
本文将尝试在内网信创服务器环境下部署Qwen3.6-35B-A3B-w8a8模型
服务器配置信息如下:
| CPU | 内存 | 硬盘 | NPU |
| 2*鲲鹏920 5220 32核 | 8*32G DDR4 2933 | 2*SATA SSD 1TB Raid1 6*SAS HDD 1TB Raid5 | 3* Atlas 300I Duo 96G |
注:因选用的Qwen3.6模型特性,仅允许调用双数GPU,但服务器配置的Atlas 300I Duo是双芯算力卡,所以一共有6个NPU芯片,每个芯片使用48G显存,具体能否使用要看该框架是否支持6个NPU并行配置
基础环境配置
由于信创要求,服务器操作系统选择统信UOS 20 1070A、同时安装Docker
安装驱动
在安装好基础环境后,现在安装计算卡驱动,进入昇腾社区官网(www.hiascend.com),选择对应计算卡的驱动,这里先选择安装以下2个驱动:
- Ascend-hdk-310p-npu-dirver_25.5.1_linux-aarch64.run
- Ascend-hdk-310p-npu-firmware_7.8.0.6.201.run
下载好后,上传至服务器,直接安装即可
chmod +x
Ascend-hdk-310p-npu-dirver_25.5.1_linux-aarch64.run
./
Ascend-hdk-310p-npu-dirver_25.5.1_linux-aarch64.run
chmod +x
Ascend-hdk-310p-npu-firmware_7.8.0.6.201.run
./
Ascend-hdk-310p-npu-firmware_7.8.0.6.201.run
安装完成后,重启服务器,验证
npu-smi info能正常输出计算卡信息即可,正常应该可以看到6颗310P
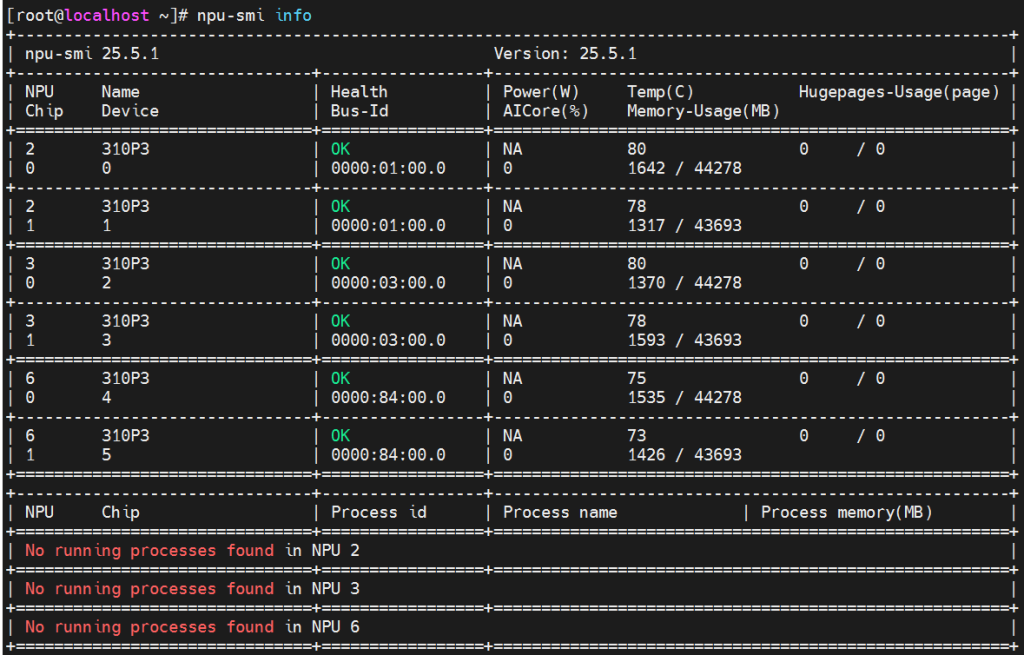
安装CANN
单有驱动还是不完整的,还需要安装驱动版本对应的CAAN,这里选择以下两个安装包:
- Ascend-cann-toolkit_9.0.0_linux-aarch64.run
- Ascend-cann-310p-ops_9.0.0_linux-aarch64.run
下载完成后上传到服务器,先安装toolkit
chmod +x
Ascend-cann-toolkit_9.0.0_linux-aarch64.run
./
Ascend-cann-toolkit_9.0.0_linux-aarch64.run
执行脚本后发现服务器报错,信息如下:
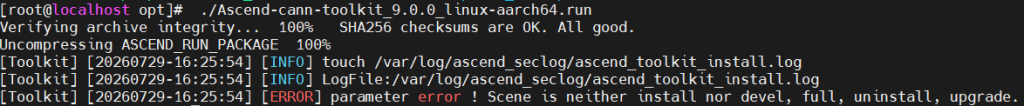
这个报错表示安装程序要求指定Scene(安装场景)不是安装失败,而是安装命令参数写错了,这里我们要确认正确的参数是什么,执行
./Ascend-cann-toolkit_9.0.0_linux-aarch64.run --help输出如下
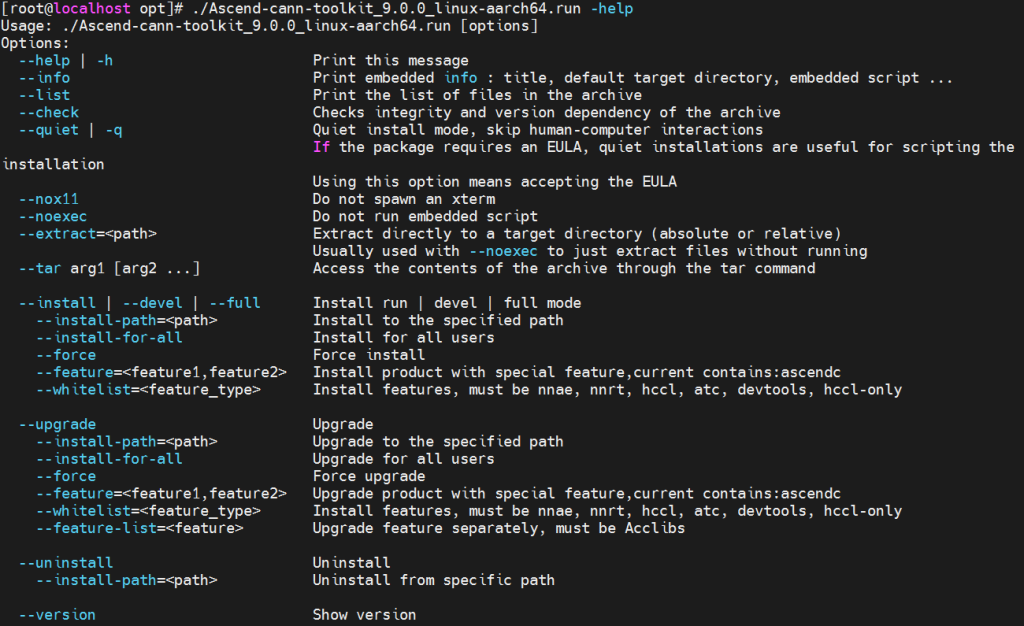
从输出我们发现,正确的安装指令应该是
./
Ascend-cann-toolkit_9.0.0_linux-aarch64.run --install
重新执行脚本,安装完成后又出现了报错

从报错看出来,是本地的python版本太低(现在安装的是python3.6.8),而CANN要求3.7或更高版本,找到问题后,我们就需要安装一个更新版本的python,这里我们选择保留原服务器上的3.6.8,重新安装一个3.10版本,在官网上下载3.10的源码包后,上传至服务器,在编译安装前,确认服务器有所需的依赖:
gcc --version
make --version
rpm -qa |grep -E "openssl|zlib|libffi|sqlite|readline|xz|bzip2"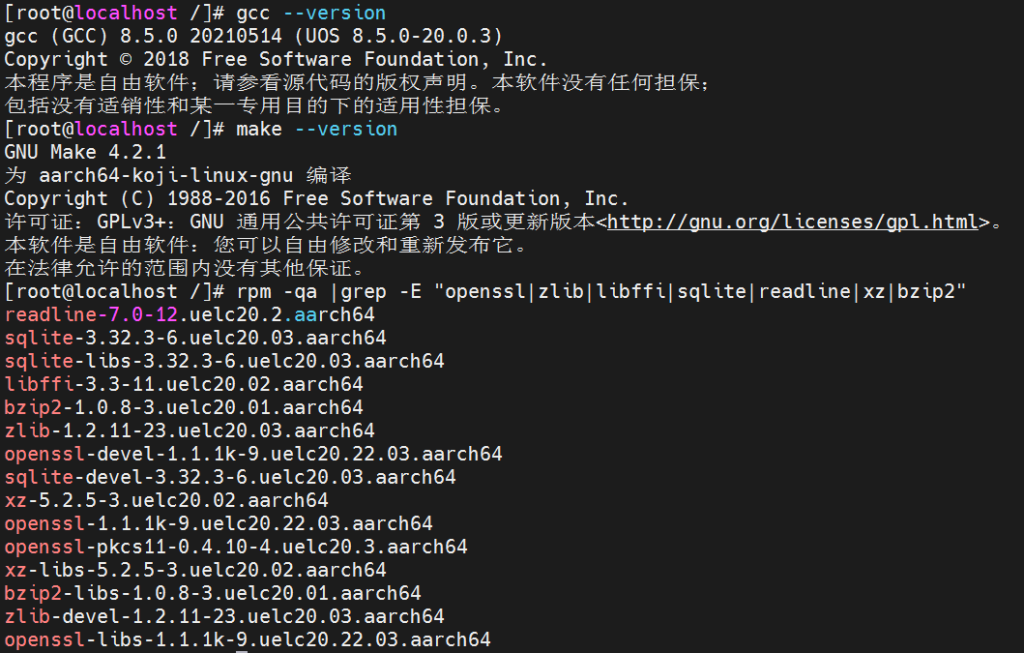
依赖全部满足后,将下载的源码包解压,执行
./configure --prefix=/opt/python3.10 --enable-optimizations
make -j$(nproc)
make altinstall
上述命令确保每一步无报错后依次执行,完成后验证
./opt/python3.10/bin/python3.10 --version
./opt/python3.10/bin/python3.10 -c "import ctypes;print('ctypes OK')"
./opt/python3.10/bin/python3.10 -c "import ssl;print(ssl OK)"
显示python版本为3.10.20,ctypes OK和ssl OK后代表成功安装
由于我们没有删除原来的python3.6,系统默认的python还是3.6,所以这里我们需要修改PATH
vim /root/.bashrc
#在末尾添加
export PATH=/opt/python3.10/bin:$PATH
export LD_LIBRARY_PATH=/opt/ptyhon3.10/lib:$LD_LIBRARY_PATH
#保存退出后,执行
source /root/.bashrc
因为我们安装的python可执行文件叫python3.10,不叫python3,还需要建立一个软链接
ln -s /opt/python3.10/bin/python3.10 /opt/python3.10/bin/python3
#刷新shell缓存
hash -r
检查是否生效
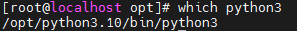
确认生效后,继续安装Ascend-cann-toolkit_9.0.0_linux-aarch64.run,发现报错了
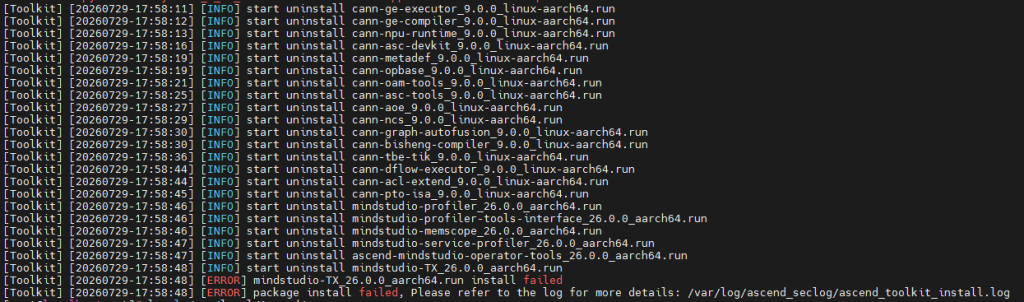
其中显示mindstudio-TX安装失败了,这个组件在服务器环境下是不需要的,所以我们重新安装,这次不安装这个组件
#卸载残留Toolkit
/usr/local/Ascend/cann-9.0.0/cann_uninstall.sh
#修改安装命令,重新安装
./Ascend-cann-toolkit_9.0.0_linux-aarch64.run \
--install \
--install-path=/usr/local/Ascend/cann-9.0.0 \
--whitelist=nnae,nnrt,atc,hccl
看到以下日志输出后,说明安装成功
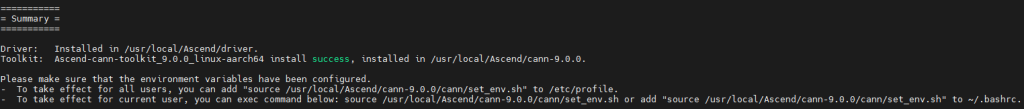
接下来加载环境
source /usr/local/Ascend/cann-9.0.0/cann/set_env.sh
#检查环境变量
echo #ASCEND_HOME_PATH
#检查ATC
which atc
#查看ATC是否完整
atc --help | head -30
都能正常输出则说明CANN安装完成
安装310 Ops
现在CANN Toolkit已经正常,可以继续安装310ops
chmod +x
Ascend-cann-310p-ops_9.0.0_linux-aarch64.run
./
Ascend-cann-310p-ops_9.0.0_linux-aarch64.run --install
安装完成后的日志
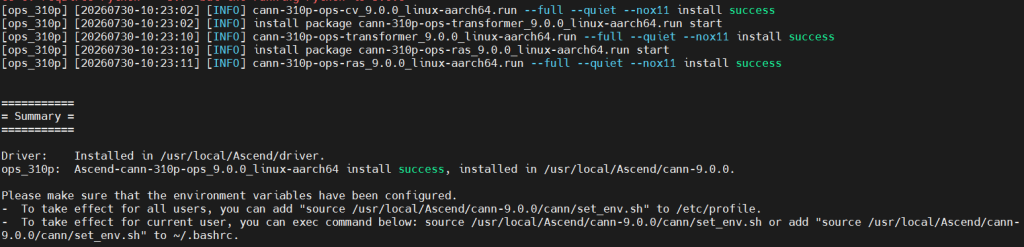
验证
ls -l /usr/local/Ascend/cann-9.0.0/cann/opp可以看到完整的目录结构,则说明安装完成
完成所有的CANN安装后,最后完整检查一遍
source /usr/local/Ascend/cann-9.0.0/cann/set_env.sh
npu-smi info
which atc
echo $ASCEND_HOME_PATH
echo $ASCEND_OPP_PATH
输出都是正常,说明CANN的安装已经完成,可以继续进行下一步了
验证Docker
现在验证安装的docker是否具备允许Ascend容器的基础条件
ls -l /dev/davinci*
ls -l /dev/davinci_manager
ls -l /dev/devmmsvm
ls -l /dev/hisi_hdc
以上四条都能正常输出,说明已经具备运行Ascend容器的基础条件
到这里,基础环境(驱动+CANN+OPP)已经全部安装完成
部署vLLM Ascend
部署vLLM有2种方式,第一种是原生本地安装,第二种是Docker+官方Ascend vLLM镜像,这里选择第二种部署方式,原因是:不污染宿主机的python环境;后续升级vLLM或PyTorch更简单;宿主机上已有业务,用docker风险更低;与官方文档一致,后续排查问题更方便。
因为服务器是内网环境,首先使用一台有互联网的windows终端,安装docker desktop,在设置中取消勾选“Use containerd for pulling and storing images”,在powersell中执行命令:
docker pull --platform linux/arm64 quay.io/ascend/vllm-ascend:v0.22.1rc1-310p等待下载完成后,还需要将镜像导出,这里选择将镜像导出到D盘,执行
docker save -o D:\vllm-ascend-v0.22.1rc1-310p.tar quay.io/ascend/vllm-ascend:v0.22.1rc1-310p导出完成后,获得一个.tar文件,将它上传到服务器,执行
docker load -i vllm-ascend-v0.22.1rc1-310p.tar导入完成后,执行
docker images | grep vllm查看是否有类似
quay.io/ascend/vllm-ascend的镜像,有了之后,说明vllm镜像已经导入,可以开始部署Qwen模型了
部署Qwen模型
现在准备部署模型,第一步,下载正确的模型,从参考文档中看,推荐从魔塔社区里下载w8a8量化模型,登录魔塔社区(www.modelscope.cn),搜索模型”Qwen3.6-35B-A3B-w8a8″,选择“Eco-Tech/Qwen3.6-35B-A3B-w8a8”,下载该模型,新建一个文件夹,命名为“Qwen”,打开git命令行,输入
git lfs install
git clone https://www.modelscope.cn/Eco-Tech/Qwen3.6-35B-A3B-w8a8.git
下载到完整的模型文件后,将其上传至服务器/opt/Qwen3.6-35B-A3B-w8a8
在服务器上执行以下命令
docker run --rm -it \
--name vllm-test \
--net=host \
--shm-size=10g \
--device /dev/davinci0 \
--device /dev/davinci1 \
--device /dev/davinci2 \
--device /dev/davinci3 \
--device /dev/davinci4 \
--device /dev/davinci5 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64:/usr/local/Ascend/driver/lib64 \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
-v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8 \
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
bash
进入容器后,先执行4条命令:
npu-smi info
python -c "import torch; import torch_npu; print(torch.__version__)"
python -c "import vllm, vllm_ascend; print('OK')"
ls /models/Qwen3.6-35B-A3B-w8a8
输出为:
npu-smi info
+--------------------------------------------------------------------------------------------------------+
| npu-smi 25.5.1 Version: 25.5.1 |
+-------------------------------+-----------------+------------------------------------------------------+
| NPU Name | Health | Power(W) Temp(C) Hugepages-Usage(page) |
| Chip Device | Bus-Id | AICore(%) Memory-Usage(MB) |
+===============================+=================+======================================================+
| 0 310P3 | OK | NA 82 0 / 0 |
| 0 0 | 0000:01:00.0 | 0 1643 / 44278 |
+-------------------------------+-----------------+------------------------------------------------------+
| 0 310P3 | OK | NA 80 0 / 0 |
| 1 1 | 0000:01:00.0 | 0 1316 / 43693 |
+===============================+=================+======================================================+
| 96 310P3 | OK | NA 82 0 / 0 |
| 0 2 | 0000:03:00.0 | 0 1371 / 44278 |
+-------------------------------+-----------------+------------------------------------------------------+
| 96 310P3 | OK | NA 80 0 / 0 |
| 1 3 | 0000:03:00.0 | 0 1592 / 43693 |
+===============================+=================+======================================================+
| 32896 310P3 | OK | NA 76 0 / 0 |
| 0 4 | 0000:84:00.0 | 0 1534 / 44278 |
+-------------------------------+-----------------+------------------------------------------------------+
| 32896 310P3 | OK | NA 74 0 / 0 |
| 1 5 | 0000:84:00.0 | 0 1426 / 43693 |
+===============================+=================+======================================================+
+-------------------------------+-----------------+------------------------------------------------------+
| NPU Chip | Process id | Process name | Process memory(MB) |
+===============================+=================+======================================================+
| No running processes found in NPU 0 |
+===============================+=================+======================================================+
| No running processes found in NPU 96 |
+===============================+=================+======================================================+
| No running processes found in NPU 32896 |
+===============================+=================+======================================================+
root@localhost:/# python -c "import torch; import torch_npu; print(torch.version)"
2.10.0+cpu
root@localhost:/# python -c "import vllm, vllm_ascend; print('OK')"
OK
root@localhost:/# ls /models/Qwen3.6-35B-A3B-w8a8
Qwen3.5-35B-A3B_best_practice.yaml quant_model_weights-00004-of-00010.safetensors
README.md quant_model_weights-00005-of-00010.safetensors
chat_template.jinja quant_model_weights-00006-of-00010.safetensors
config.json quant_model_weights-00007-of-00010.safetensors
configuration.json quant_model_weights-00008-of-00010.safetensors
generation_config.json quant_model_weights-00009-of-00010.safetensors
merges.txt quant_model_weights-00010-of-00010.safetensors
preprocessor_config.json quant_model_weights.safetensors.index.json
quant_model_description.json tokenizer.json
quant_model_weights-00001-of-00010.safetensors tokenizer_config.json
quant_model_weights-00002-of-00010.safetensors video_preprocessor_config.json
quant_model_weights-00003-of-00010.safetensors vocab.json
这里根据输出可以看到,6个310P正常、/dev/davinci*挂载正常、Driver挂载正常、容器可以访问NPU,但有一个细节需要注意
python -c "import torch; import torch_npu; print(torch.version)"
2.10.0+cpu
按理来说应该输出2.6.x或2.x.x+npu,但这里输出了+cpu,再次确认,执行
python - <<'EOF'
import torch
import torch_npu
print(torch.version)
print(torch.version.cuda)
print(torch.npu.is_available())
print(torch.npu.device_count())
EOF
输出为:
2.10.0+cpu
None
True
6
说明镜像里的PyTorch是CPU版,但通过torch_npu插件接管NPU,这下Ascend镜像里是正常的。
接下来,确认是否有Ascend量化模式和是否支持tensor parallel
vllm serve --help |grep quantization
vllm serve --help |grep tensor-parallel-size
输出为
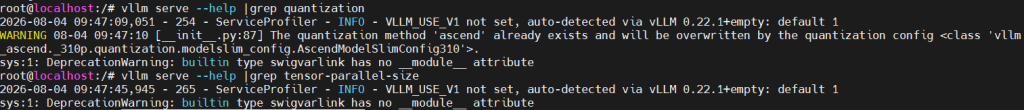
说明没有问题,可以启动了,以下操作继续在容器里进行
设置环境变量
export VLLM_USE_V1=1
export PYTORCH_NPU_ALLOC_CONF=expandable_segments:True
export ASCEND_RT_VISIBLE_DEVICES=0,1,2,3,4,5
执行启动命令
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--tensor-parallel-size 6
输出报错为
root@localhost:/# vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--tensor-parallel-size 6
INFO 08-04 09:58:21 [init.py:44] Available plugins for group vllm.platform_plugins:
INFO 08-04 09:58:21 [init.py:46] - ascend -> vllm_ascend:register
INFO 08-04 09:58:21 [init.py:49] All plugins in this group will be loaded. Set VLLM_PLUGINS to control which plugins to load.
INFO 08-04 09:58:21 [init.py:238] Platform plugin ascend is activated
INFO 08-04 09:58:21 [platform.py:60] Breakable cudagraph is force disabled on Ascend because DeepSeek V4 PIECEWISE cudagraph is not supported yet.
INFO 08-04 09:58:27 [importing.py:69] Triton not installed or not compatible; certain GPU-related functions will not be available.
WARNING 08-04 09:58:30 [registry.py:984] Model architecture DeepseekV4ForCausalLM is already registered, and will be overwritten by the new model class vllm_ascend.models.deepseek_v4:AscendDeepseekV4ForCausalLM.
WARNING 08-04 09:58:30 [registry.py:984] Model architecture DeepSeekV4MTPModel is already registered, and will be overwritten by the new model class vllm_ascend.models.deepseek_v4_mtp:DeepSeekV4MTP.
INFO 08-04 09:58:30 [init.py:115] Registered model loader <class 'vllm_ascend.model_loader.netloader.netloader.ModelNetLoaderElastic'> with load format netloader
INFO 08-04 09:58:30 [init.py:115] Registered model loader <class 'vllm_ascend.model_loader.rfork.rfork_loader.RForkModelLoader'> with load format rfork
WARNING 08-04 09:58:30 [init.py:87] The quantization method 'ascend' already exists and will be overwritten by the quantization config .
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344]
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344] █ █ █▄ ▄█
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344] ▄▄ ▄█ █ █ █ ▀▄▀ █ version 0.22.1
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344] █▄█▀ █ █ █ █ model /models/Qwen3.6-35B-A3B-w8a8
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344] ▀▀ ▀▀▀▀▀ ▀▀▀▀▀ ▀ ▀
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:344]
(APIServer pid=307) INFO 08-04 09:58:30 [utils.py:278] non-default args: {'model_tag': '/models/Qwen3.6-35B-A3B-w8a8', 'model': '/models/Qwen3.6-35B-A3B-w8a8', 'tensor_parallel_size': 6}
(APIServer pid=307) WARNING 08-04 09:58:30 [envs.py:2057] Unknown vLLM environment variable detected: VLLM_USE_V1
(APIServer pid=307) INFO 08-04 09:58:47 [model.py:617] Resolved architecture: Qwen3_5MoeForConditionalGeneration
(APIServer pid=307) INFO 08-04 09:58:47 [model.py:1752] Using max model len 262144
(APIServer pid=307) Qwen2VLImageProcessorFast is deprecated. The Fast suffix for image processors has been removed; use Qwen2VLImageProcessor instead.
(APIServer pid=307) Traceback (most recent call last):
(APIServer pid=307) File "/usr/local/python3.12.13/bin/vllm", line 6, in
(APIServer pid=307) sys.exit(main())
(APIServer pid=307) ^^^^^^
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/cli/main.py", line 92, in main
(APIServer pid=307) args.dispatch_function(args)
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/cli/serve.py", line 148, in cmd
(APIServer pid=307) uvloop.run(run_server(args))
(APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/site-packages/uvloop/init.py", line 96, in run
(APIServer pid=307) return asyncio.run( (APIServer pid=307) ^^^^^^^^^^^^^^ (APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/asyncio/runners.py", line 195, in run (APIServer pid=307) return runner.run(main) (APIServer pid=307) ^^^^^^^^^^^^^^^^ (APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/asyncio/runners.py", line 118, in run (APIServer pid=307) return self._loop.run_until_complete(task) (APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ (APIServer pid=307) File "uvloop/loop.pyx", line 1518, in uvloop.loop.Loop.run_until_complete (APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/site-packages/uvloop/__init.py", line 48, in wrapper
(APIServer pid=307) return await main
(APIServer pid=307) ^^^^^^^^^^
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/openai/api_server.py", line 678, in run_server
(APIServer pid=307) await run_server_worker(listen_address, sock, args, **uvicorn_kwargs)
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/openai/api_server.py", line 692, in run_server_worker
(APIServer pid=307) async with build_async_engine_client(
(APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^^^^^^
(APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/contextlib.py", line 210, in aenter
(APIServer pid=307) return await anext(self.gen)
(APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/openai/api_server.py", line 100, in build_async_engine_client
(APIServer pid=307) async with build_async_engine_client_from_engine_args(
(APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
(APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/contextlib.py", line 210, in aenter
(APIServer pid=307) return await anext(self.gen)
(APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/entrypoints/openai/api_server.py", line 124, in build_async_engine_client_from_engine_args
(APIServer pid=307) vllm_config = engine_args.create_engine_config(usage_context=usage_context)
(APIServer pid=307) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
(APIServer pid=307) File "/vllm-workspace/vllm/vllm/engine/arg_utils.py", line 2224, in create_engine_config
(APIServer pid=307) config = VllmConfig(
(APIServer pid=307) ^^^^^^^^^^^
(APIServer pid=307) File "/usr/local/python3.12.13/lib/python3.12/site-packages/pydantic/_internal/_dataclasses.py", line 121, in init
(APIServer pid=307) s.pydantic_validator.validate_python(ArgsKwargs(args, kwargs), self_instance=s)
(APIServer pid=307) pydantic_core._pydantic_core.ValidationError: 1 validation error for VllmConfig
(APIServer pid=307) Assertion failed, 8192 is not divisible by 6 [type=assertion_error, input_value=ArgsKwargs((), {'model_co… 'shutdown_timeout': 0}), input_type=ArgsKwargs]
(APIServer pid=307) For further information visit https://errors.pydantic.dev/2.13/v/assertion_error
(APIServer pid=307) [ERROR] 2026-08-04-09:58:47 (PID:307, Device:-1, RankID:-1) ERR99999 UNKNOWN applicaiton exception
(APIServer pid=307) sys:1: DeprecationWarning: builtin type swigvarlink has no module attribute
从日志看出,关键报错为:
Assertion failed, 8192 is not divisible by 6和我们之前想的一样,Qwen3.6-35B-A3B的attention hidden size /tensor parallel切分要求必须能被TP数整除,而部署的模型
hidden_size=2048
num_attention_heads=16
head_dim=256
这里VLLM检查的是attention heads或相关维度,8192不能被6整除,所以,3张卡不支持,这次尝试2张卡,修改启动脚本为:
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--tensor-parallel-size 4
启动依然报错
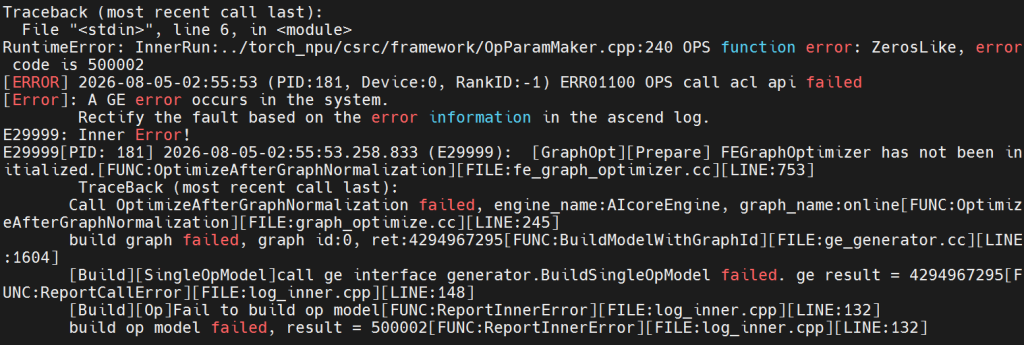
继续排查,在容器里执行
find /usr/local/Ascend/cann-9.1.0-beta.1 \
-name "libfe.so" \ -o -name "libgraph.so" \
-o -name "libge_executor.so" \
-o -name "libge_runner.so"

python3 - <<'EOF'
import os
import ctypes

libs = [
"libgraph.so",
"libge_executor.so",
"libge_runner.so",
"libfe.so"
]

for lib in libs:
    try:
        ctypes.CDLL(lib)
        print(lib, "OK")
    except Exception as e:
        print(lib, e)
EOF
输出
root@6f8bffe199ff:/workspace# find /usr/local/Ascend/cann-9.1.0-beta.1 \
-name "libfe.so" \ -o -name "libgraph.so" \
-o -name "libge_executor.so" \
-o -name "libge_runner.so"
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/libge_runner.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/libgraph.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/linux/aarch64/libge_runner.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/linux/aarch64/libgraph.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/linux/x86_64/libge_runner.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/linux/x86_64/libgraph.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/devlib/minios/aarch64/libgraph.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/libge_executor.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/libge_runner.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/libgraph.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/libgraph_base.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/libgraphtuner_executor.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/plugin/opskernel/libfe.so
/usr/local/Ascend/cann-9.1.0-beta.1/aarch64-linux/lib64/plugin/opskernel/libgraph_tuner.so
/usr/local/Ascend/cann-9.1.0-beta.1/python/site-packages/ge/_capi/libgraph_wrapper.so
root@6f8bffe199ff:/workspace# python3 - <<'EOF'
import os
import ctypes
libs = [
“libgraph.so”,
“libge_executor.so”,
“libge_runner.so”,
“libfe.so”
]
for lib in libs:
try:
ctypes.CDLL(lib)
print(lib, "OK")
except Exception as e:
print(lib, e)
EOF
libgraph.so OK
libge_executor.so /usr/local/Ascend/cann-9.1.0-beta.1/lib64/libhybrid_executor.so: undefined symbol: _ZN4gert16AllocatorFactory6CreateERKNS_15TensorPlacementE
libge_runner.so OK
libfe.so OK
从输出看到,原因可能是
libge_executor.so
→ 加载 libhybrid_executor.so
→ 找不到 libgert.so 中的符号
gert::AllocatorFactory::Create(gert::TensorPlacement const&)
看日志输出
grep -n -i -E \
"error|failed|fail|invalid|not found|permission|initialize|optimizer|plugin|soc|opp|fe" \
/root/ascend/log/debug/plog/plog-672_* 2>/dev/null | head -100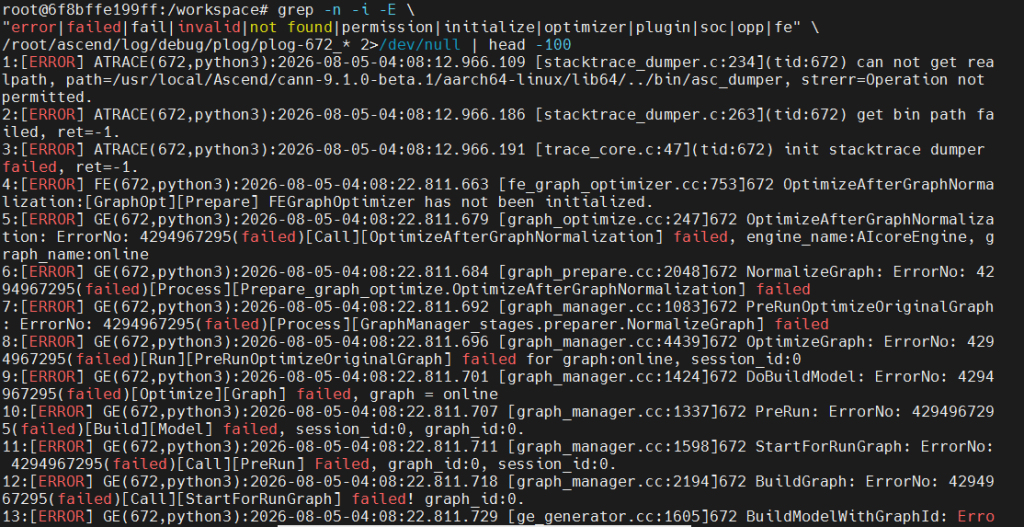
从日志中又能看到新的线索
can not get realpath
path=…/bin/asc_dumper
strerr=Operation not permitted
本地的docker版本为19.03.15,怀疑可能是老版本Docker的默认seccomp/capability限制,阻止了CANN组件需要的系统调用或路径访问,导致FE初始化流程没有完整执行,再次尝试验证问题,退出当前容器,重新启动一个seccomp不受限的单卡测试容器:
docker run --rm -it \
--name vllm-seccomp-test \
--security-opt seccomp=unconfined \
--shm-size=1g \
--device /dev/davinci0 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
bash
进入后测试
export ASCEND_LAUNCH_BLOCKING=1
python3 - <<'EOF'
import torch
import torch_npu

torch.npu.set_device(0)
x = torch.zeros((10,), dtype=torch.float16, device="npu")
torch.npu.synchronize()

print("NPU basic op OK")
print(x.shape, x.dtype, x.device)
EOF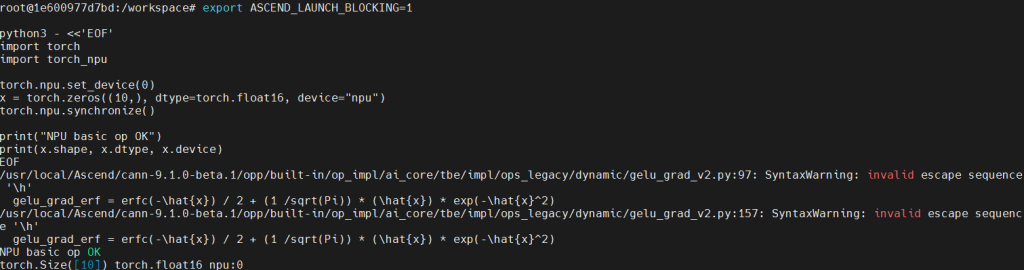
这次执行成功了,看来之前的猜想是正确的,原因就是Docker19.03的默认seccomp策略阻止了CANN9.1容器所需的系统调用,导致FEGraphOptimizer初始化失败,接下来,可以正式创建容器了,退出当前测试容器,先按照官方验证方式只使用一张Atlas 300I Duo,也就是设备0、1,TP=2
docker run -it \
--name qwen36-vllm \
--net=host \
--security-opt seccomp=unconfined \
--shm-size=32g \
--device /dev/davinci0 \
--device /dev/davinci1 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
-v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8 \
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
bash
这里不加参数–rm,推出后还可以再进入容器,进入容器后执行
unset VLLM_USE_V1
export ASCEND_RT_VISIBLE_DEVICES=0,1
export PYTORCH_NPU_ALLOC_CONF=expandable_segments:True
再启动
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8080 \
--tensor-parallel-size 2 \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 16 \
--no-enable-prefix-caching \
--trust-remote-code \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'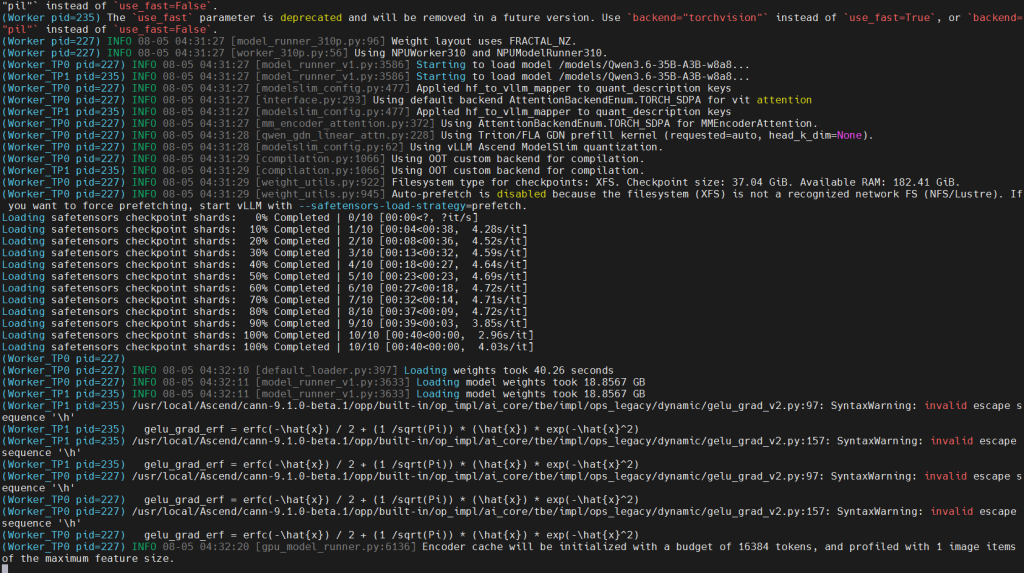
从启动日志来看,似乎启动成功了,没有报错,继续等待完成编译,这可能还需要几分钟到几十分钟
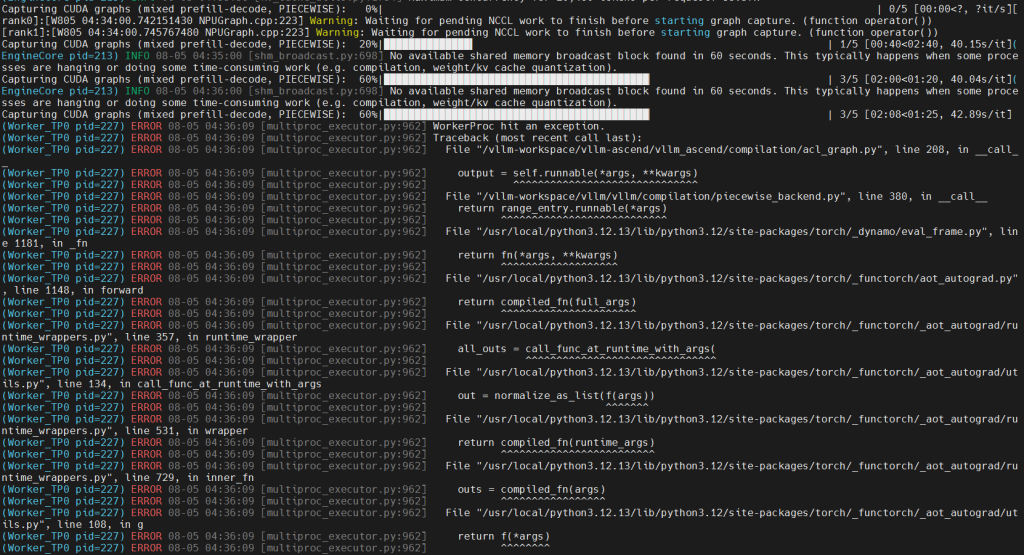
等待了一段时间,又发现了报错,从报错看到,模型其实已经完全加载成功了,失败的阶段是“vLLM进入Graph Capture(ACLGraph/CUDAGraph)优化阶段”,问题可能是启动命令里没有–enforce-eager,所以vLLM仍然按默认方式进入了Capturing CUDA graphs (mixed prefill-decode, PIECEWISE),再次尝试重新启动
//停止当前失败进程
pkill -9 -f vllm
//确认没有残留
ps -ef | grep -E 'vllm|EngineCore|Worker_TP' | grep -v grep
//执行
unset ASCEND_LAUNCH_BLOCKING
unset VLLM_USE_V1

export ASCEND_RT_VISIBLE_DEVICES=0,1
export PYTORCH_NPU_ALLOC_CONF=expandable_segments:True
//再次启动
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
  --host 0.0.0.0 \
  --port 8080 \
  --tensor-parallel-size 2 \
  --dtype float16 \
  --quantization ascend \
  --served-model-name qwen3.6 \
  --gpu-memory-utilization 0.90 \
  --max-model-len 20480 \
  --max-num-seqs 16 \
  --no-enable-prefix-caching \
  --trust-remote-code \
  --enforce-eager \
  --additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'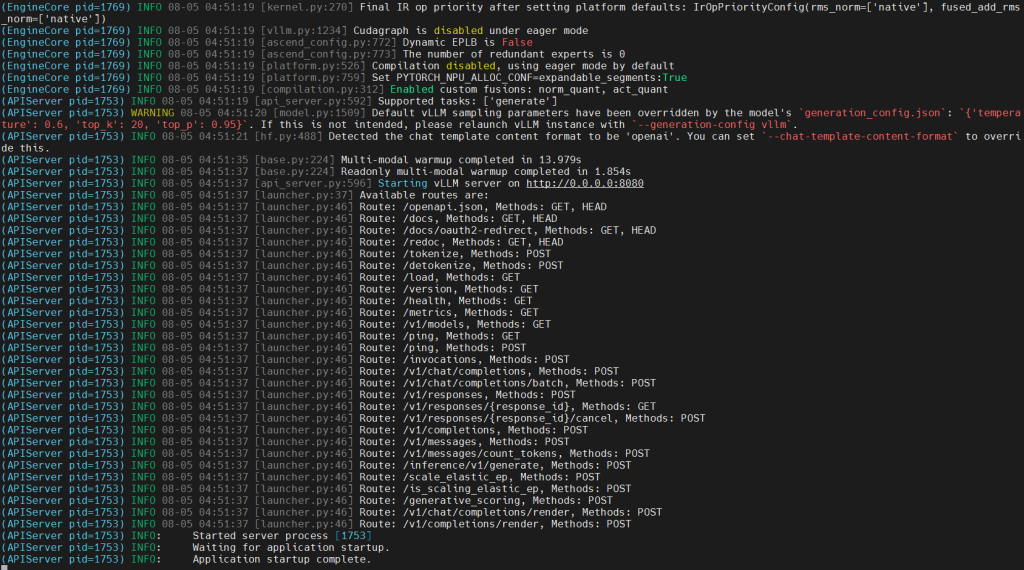
这次看日志完全启动结束,而且成功了,接下来测试模型,在宿主机上执行
curl http://127.0.0.1:8080/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model":"qwen3.6",
"messages":[
{
"role":"user",
"content":"你好,请介绍一下你自己。"
}
],
"temperature":0.7,
"max_tokens":128
}'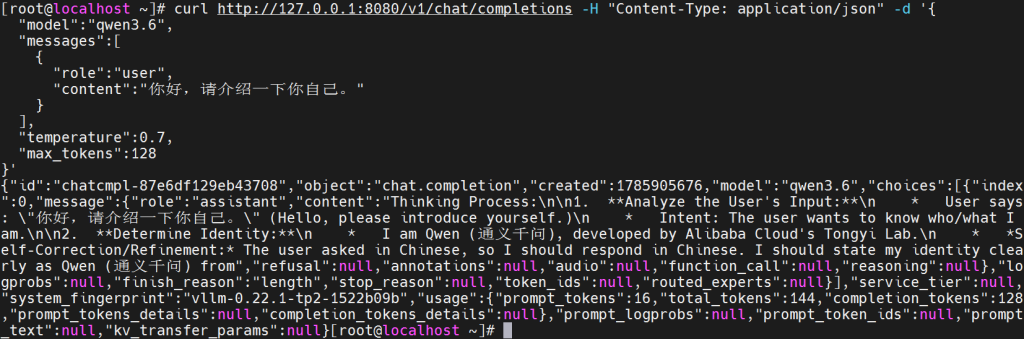
成功了,Qwen回复了问题,不过他还输出了推理过程(CoT),格式不对,还需要微调,输入
cat /models/Qwen3.6-35B-A3B-w8a8/config.json | grep -i reasoning
cat /models/Qwen3.6-35B-A3B-w8a8/generation_config.json
输出为
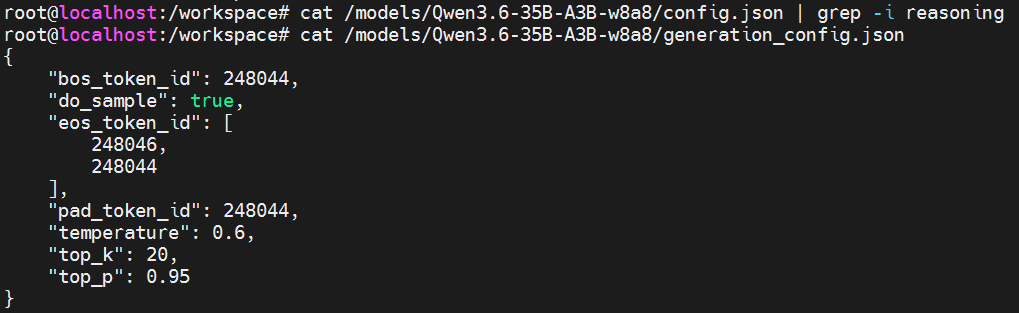
第一条命令没有任何输出,第二条命令的输出里也没有enable_thinking、reasoning、thinking、chat_template,说明模型配置本身没有开启thinking,再输入
python3 -m vllm.entrypoints.openai.api_server --help |grep -i reasoning
里面有–reasoning-parser,这说明vLLM支持–reasoning-parser,要关闭它只需要修改启动参数
如果要关闭思考模式,请求里增加
"chat_template_kwargs": {
"enable_thinking": false
}
如果要保留思考,但分开思考和答案,重启vLLM时增加
--reasoning-parser qwen3这里不需要保留思考,所以再次测试,加上参数
curl http://127.0.0.1:8080/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3.6",
"messages": [
{
"role": "user",
"content": "你好,请介绍一下你自己?"
}
],
"temperature": 0,
"max_tokens": 64,
"chat_template_kwargs": {
"enable_thinking": false
}
}'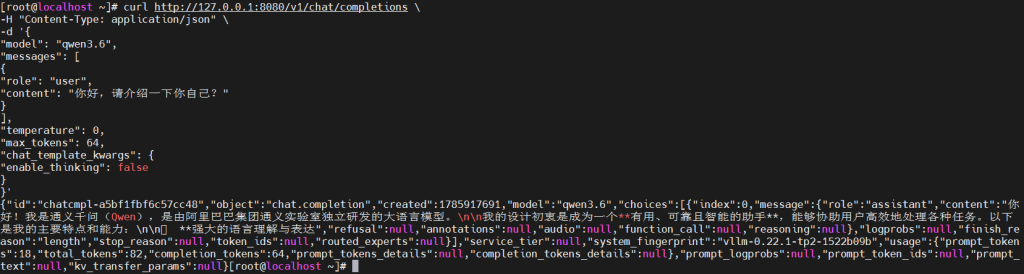
这次输出不带思考了,但返回里有
"finish_reason":"length"说明回答被截断了,因为对话参数设置的”max_tokens”:64,后续可以改成512
单卡容器测试没有问题后,开始尝试使用双卡,先停掉当前双NPU容器
docker ps | grep vllm
docker stop qwen36-vllm
docker rm qwen36-vllm
在宿主机执行
docker run -d \
--name qwen36-vllm-prod \
--restart unless-stopped \
--net=host \
--security-opt seccomp=unconfined \
--shm-size=32g \
--device /dev/davinci0 \
--device /dev/davinci1 \
--device /dev/davinci2 \
--device /dev/davinci3 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
-v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8:ro \
-e ASCEND_RT_VISIBLE_DEVICES=0,1,2,3 \
-e PYTORCH_NPU_ALLOC_CONF=expandable_segments:True \
-e OMP_PROC_BIND=false \
-e OMP_NUM_THREADS=1 \
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8080 \
--tensor-parallel-size 4 \
--distributed-executor-backend mp \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 32 \
--max-num-batched-tokens 8192 \
--no-enable-prefix-caching \
--trust-remote-code \
--enforce-eager \
--reasoning-parser qwen3 \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'
第一次启动需要时间,监控日志和NPU使用情况
docker logs -f qwen36-vllm-prod
watch -n 2 npu-smi info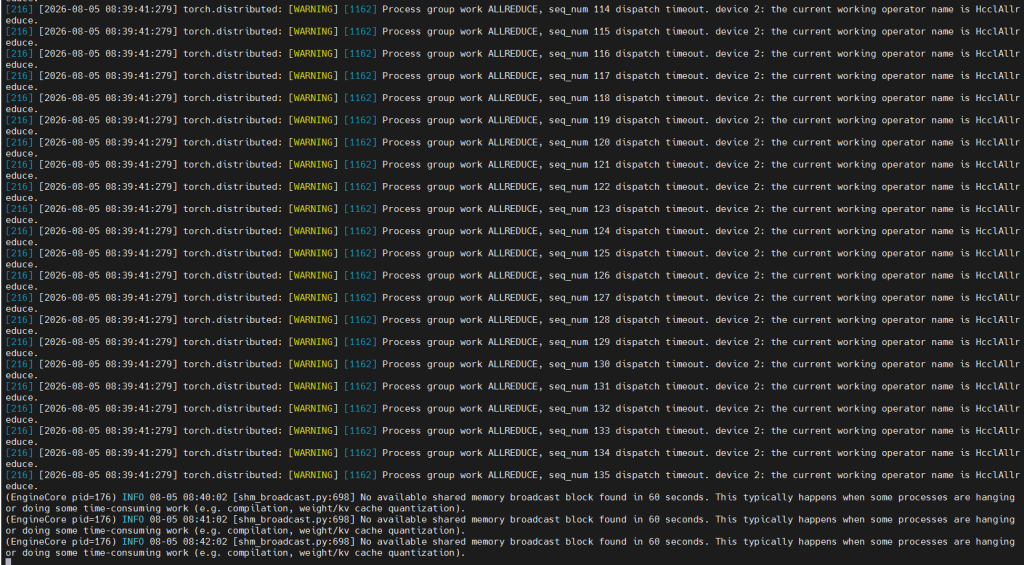
日志又有报错了,这次日志显示HCCL多卡通信卡死了,先排除硬件问题,用第二张卡单独运行容器试试
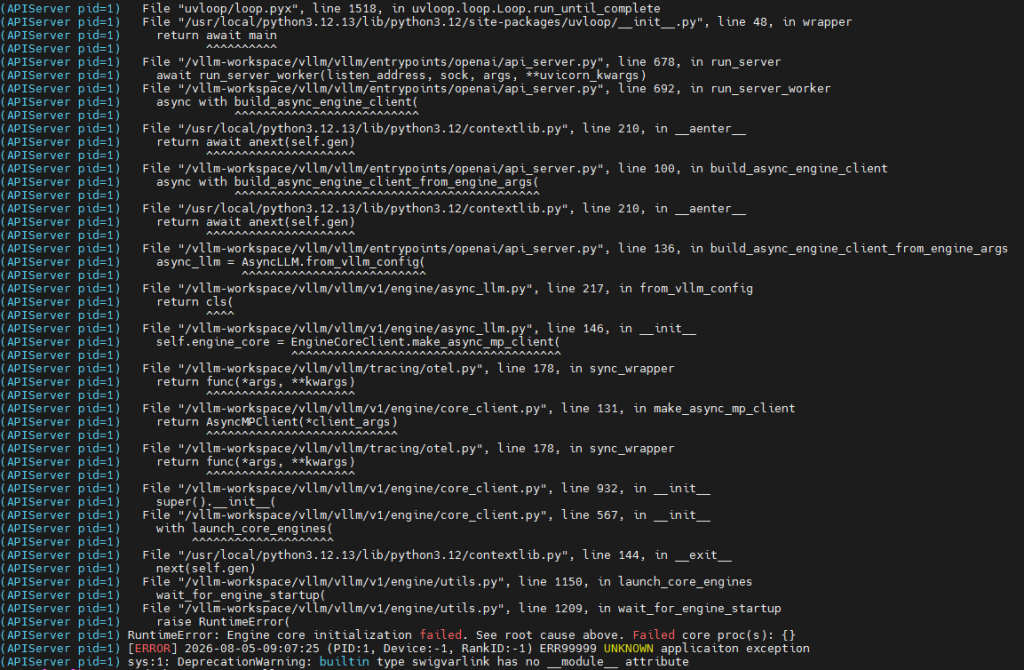
发现还是报错,从头开始排查,关闭所有相关的容器,启动一个测试容器,不启动VLLM
docker run --rm -it \
  --name vllm-test \
  --net=host \
  --security-opt seccomp=unconfined \
  --shm-size=32g \
  --device /dev/davinci0 \
  --device /dev/davinci1 \
  --device /dev/davinci2 \
  --device /dev/davinci3 \
  --device /dev/davinci4 \
  --device /dev/davinci5 \
  --device /dev/davinci_manager \
  --device /dev/devmm_svm \
  --device /dev/hisi_hdc \
  -v /usr/local/dcmi:/usr/local/dcmi \
  -v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
  -v /usr/local/Ascend/driver/lib64:/usr/local/Ascend/driver/lib64 \
  -v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
  -v /etc/ascend_install.info:/etc/ascend_install.info \
  -v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8:ro \
  quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
  bash
确认镜像自己的CANN还在
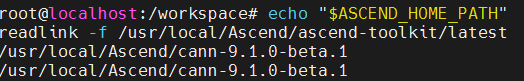
再测试6个逻辑设备
python3 - <<'EOF'
import torch
import torch_npu
print("device_count =", torch.npu.device_count())

for i in range(torch.npu.device_count()):
try:
torch.npu.set_device(i)
x = torch.zeros((1,), dtype=torch.float16, device=f"npu:{i}")
torch.npu.synchronize()
print(f"device {i}: OK")
except Exception as e:
print(f"device {i}: FAILED -> {e}")
EOF
6个逻辑设备都正常后,测试第二张卡
export ASCEND_RT_VISIBLE_DEVICES=2,3
unset ASCEND_LAUNCH_BLOCKING
unset VLLM_USE_V1
确认可见设备数
python3 - <<'EOF'
import torch
import torch_npu

print("device_count =", torch.npu.device_count())

for i in range(torch.npu.device_count()):
torch.npu.set_device(i)
x = torch.zeros((1,), dtype=torch.float16, device=f"npu:{i}")
torch.npu.synchronize()
print("logical device", i, "OK")
EOF
都显示OK后,启动TP=2
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8080 \
--tensor-parallel-size 2 \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 16 \
--no-enable-prefix-caching \
--trust-remote-code \
--enforce-eager \
--reasoning-parser qwen3 \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'
2,3可以启动成功,同样的方式测试4,5,也成功,说明三张卡都没问题,但卡间通信有问题,可能由于多个原因(安装了三张卡但使用两张),就不再深究了,使用另一个替代方案,三张卡单独部署三套TP=2的模型,端口分别是8080,8081和8082,使用nginx分发请求,实现负载均衡,因为单卡跑该模型绰绰有余,部署集群反而增加了系统的稳定性
关闭所有qwen的测试容器,确保三个端口都通
创建公共容器
docker run -d \
--name qwen36-cluster \
--restart unless-stopped \
--net=host \
--ipc=host \
--privileged \
--security-opt seccomp=unconfined \
--shm-size=32g \
\
--device /dev/davinci0 \
--device /dev/davinci1 \
--device /dev/davinci2 \
--device /dev/davinci3 \
--device /dev/davinci4 \
--device /dev/davinci5 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
\
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64:/usr/local/Ascend/driver/lib64 \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
-v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8:ro \
\
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
sleep infinity
进入容器
docker exec -it qwen36-cluster bash启动实例一(8080)
ASCEND_RT_VISIBLE_DEVICES=0,1 \
OMP_NUM_THREADS=1 \
OMP_PROC_BIND=false \
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8080 \
--tensor-parallel-size 2 \
--distributed-executor-backend mp \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 16 \
--no-enable-prefix-caching \
--trust-remote-code \
--enforce-eager \
--reasoning-parser qwen3 \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'
新建一个ssh窗口,进入容器,启动实例二(8081)
ASCEND_RT_VISIBLE_DEVICES=2,3 \
OMP_NUM_THREADS=1 \
OMP_PROC_BIND=false \
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8081 \
--tensor-parallel-size 2 \
--distributed-executor-backend mp \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 16 \
--no-enable-prefix-caching \
--trust-remote-code \
--enforce-eager \
--reasoning-parser qwen3 \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'
新建一个ssh窗口,进入容器,启动实例三(8082)
ASCEND_RT_VISIBLE_DEVICES=4,5 \
OMP_NUM_THREADS=1 \
OMP_PROC_BIND=false \
vllm serve /models/Qwen3.6-35B-A3B-w8a8 \
--host 0.0.0.0 \
--port 8082 \
--tensor-parallel-size 2 \
--distributed-executor-backend mp \
--dtype float16 \
--quantization ascend \
--served-model-name qwen3.6 \
--gpu-memory-utilization 0.90 \
--max-model-len 20480 \
--max-num-seqs 16 \
--no-enable-prefix-caching \
--trust-remote-code \
--enforce-eager \
--reasoning-parser qwen3 \
--additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}'
都启动成功,验证没有问题后,现在删除容器,开始正式环境启动
持久化启动脚本
在宿主机上创建目录
mkdir -p /opt/qwen36-runtime/logs创建启动脚本
cat > /opt/qwen36-runtime/start-all.sh <<'EOF'
#!/bin/bash

set -uo pipefail

MODEL_PATH="/models/Qwen3.6-35B-A3B-w8a8"
LOG_DIR="/runtime/logs"

mkdir -p "${LOG_DIR}"

cleanup() {
    trap - EXIT INT TERM

    echo "Stopping all vLLM instances..."

    for pid_file in "${LOG_DIR}"/*.pid; do
        [ -f "${pid_file}" ] || continue
        pid="$(cat "${pid_file}")"

        if kill -0 "${pid}" 2>/dev/null; then
            kill "${pid}" 2>/dev/null || true
        fi
    done

    wait 2>/dev/null || true
}

trap cleanup EXIT INT TERM

start_instance() {
    local devices="$1"
    local port="$2"
    local name="$3"
    local log_file="${LOG_DIR}/${name}.log"
    local pid_file="${LOG_DIR}/${name}.pid"

    echo "Starting ${name}: devices=${devices}, port=${port}"

    env \
        ASCEND_RT_VISIBLE_DEVICES="${devices}" \
        OMP_NUM_THREADS=1 \
        OMP_PROC_BIND=false \
        vllm serve "${MODEL_PATH}" \
            --host 0.0.0.0 \
            --port "${port}" \
            --tensor-parallel-size 2 \
            --distributed-executor-backend mp \
            --dtype float16 \
            --quantization ascend \
            --served-model-name qwen3.6 \
            --gpu-memory-utilization 0.90 \
            --max-model-len 20480 \
            --max-num-seqs 16 \
            --no-enable-prefix-caching \
            --trust-remote-code \
            --enforce-eager \
            --reasoning-parser qwen3 \
            --additional-config '{"ascend_compilation_config":{"enable_npugraph_ex":false}}' \
            >"${log_file}" 2>&1 &

    echo $! > "${pid_file}"
}

rm -f "${LOG_DIR}"/*.pid

start_instance "0,1" 8080 "qwen36-01"

echo "Waiting for instance 1 initialization..."
sleep 90

start_instance "2,3" 8081 "qwen36-02"

echo "Waiting for instance 2 initialization..."
sleep 90

start_instance "4,5" 8082 "qwen36-03"

echo "All vLLM processes have been launched."

# 任一实例退出,整个容器退出,由 Docker restart 策略重新拉起
wait -n

echo "A vLLM instance exited unexpectedly."
exit 1
EOF
,脚本里将三个实例启动时间间隔90秒,避免三个进程同时启动,资源占用过大,增加执行权限
chmod +x /opt/qwen36-runtime/start-all.sh创建正式容器
docker run -d \
--name qwen36-cluster \
--restart unless-stopped \
--net=host \
--security-opt seccomp=unconfined \
--shm-size=64g \
--device /dev/davinci0 \
--device /dev/davinci1 \
--device /dev/davinci2 \
--device /dev/davinci3 \
--device /dev/davinci4 \
--device /dev/davinci5 \
--device /dev/davinci_manager \
--device /dev/devmm_svm \
--device /dev/hisi_hdc \
-v /usr/local/dcmi:/usr/local/dcmi \
-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
-v /usr/local/Ascend/driver/lib64:/usr/local/Ascend/driver/lib64 \
-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
-v /etc/ascend_install.info:/etc/ascend_install.info \
-v /opt/Qwen3.6-35B-A3B-w8a8:/models/Qwen3.6-35B-A3B-w8a8:ro \
-v /opt/qwen36-runtime:/runtime \
quay.io/ascend/vllm-ascend:v0.22.1rc1-310p \
bash /runtime/start-all.sh
查看总启动状态
docker ps --filter name=qwen36-cluster三个实例的日志都在/opt/qwen36-runtime/logs/路径下,三个实例都启动完成后,验证
for port in 8080 8081 8082; do
echo "===== ${port} ====="
curl -s --max-time 10 "http://127.0.0.1:${port}/v1/models"
echo
done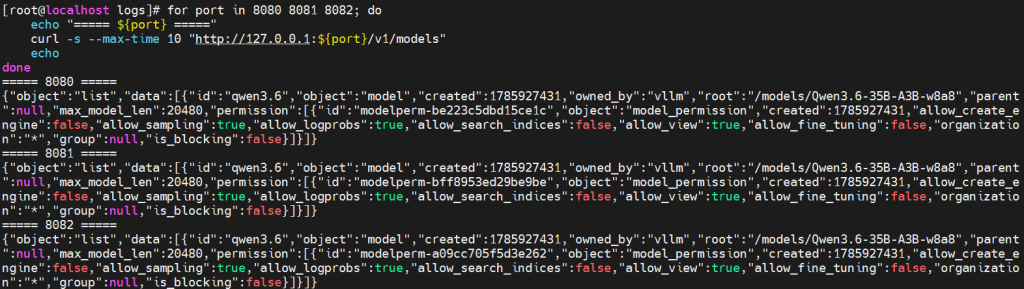
这样就说明三个实例都成功了
配置Nginx负载均衡
安装nginx到任意目录,这里我选择安装到/opt/nginx-1.28.3-qwen/目录下,安装完成后,确认主配置是否包含conf.d
grep -n 'conf.d' /usr/local/nginx/conf/nginx.conf没有输出,在http{……}中加入:
include /opt/nginx-1.28.3-qwen/conf/conf.d/*.conf;然后创建目录
mkdir -p /opt/nginx-1.28.3-qwen/conf/conf.d创建Qwen代理配置
cat > /opt/nginx-1.28.3-qwen/conf/conf.d/qwen36.conf <<'EOF'
upstream qwen36_backend {
    least_conn;

    server 127.0.0.1:8080 max_fails=2 fail_timeout=30s;
    server 127.0.0.1:8081 max_fails=2 fail_timeout=30s;
    server 127.0.0.1:8082 max_fails=2 fail_timeout=30s;

    keepalive 32;
}

server {
    listen 8088;
    server_name _;

    client_max_body_size 100m;

    location = /health {
        access_log off;
        default_type application/json;
        return 200 '{"status":"ok","service":"qwen3.6"}';
    }

    location /v1/ {
        proxy_pass http://qwen36_backend;

        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;

        # 流式输出必须关闭缓冲
        proxy_buffering off;
        proxy_cache off;
        proxy_request_buffering off;

        proxy_connect_timeout 30s;
        proxy_send_timeout 3600s;
        proxy_read_timeout 3600s;

        add_header X-Accel-Buffering no always;
    }
}
EOF
外部统一访问地址为
http://服务器IP://8088/v1nginx会使用least_conn,优先把新请求交给当前连接数较少的实例,更适合长文生成
检查配置

没问题后,启动nginx
./opt/nginx-1.28.3-qwen/sbin/nginx测试
curl -s http://:127.0.0.1:8088/v1/models普通生成测试
curl -s http://127.0.0.1:8088/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3.6",
"messages": [
{
"role": "user",
"content": "请撰写一段约三百字的正式工作情况说明。"
}
],
"temperature": 0.1,
"top_p": 0.9,
"max_tokens": 1024,
"chat_template_kwargs": {
"enable_thinking": false
}
}'
流式生成测试
curl -N http://127.0.0.1:8088/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3.6",
"messages": [
{
"role": "user",
"content": "请撰写一段简短的工作总结。"
}
],
"stream": true,
"temperature": 0.1,
"max_tokens": 512,
"chat_template_kwargs": {
"enable_thinking": false
}
}'
都能够正常输出,说明负载均衡代理已经完成,要注意,目前还没有加API-KEY验证,后续可以加上,防止任何人都能访问
至此,我们就完成了整个模型的部署,后续再优化开机自启,健康度检查的功能。
参考实施文档:https://docs.vllm.ai/projects/ascend/en/latest/tutorials/models/Qwen3.6-35B-A3B.html#31-model-weight

